Claude 101 EP1: AI ตอบกว้าง ใช้ไม่ได้?
วิดีโอ
ทิปของตอนนี้ (Tip)
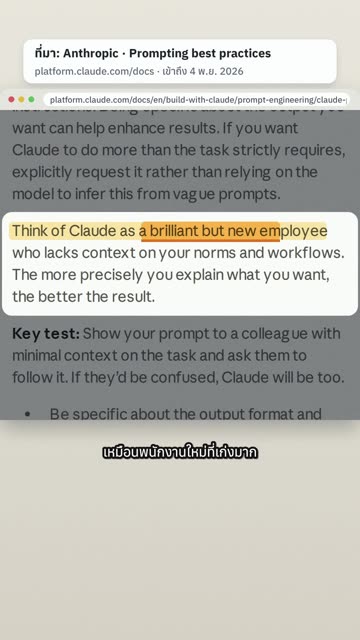
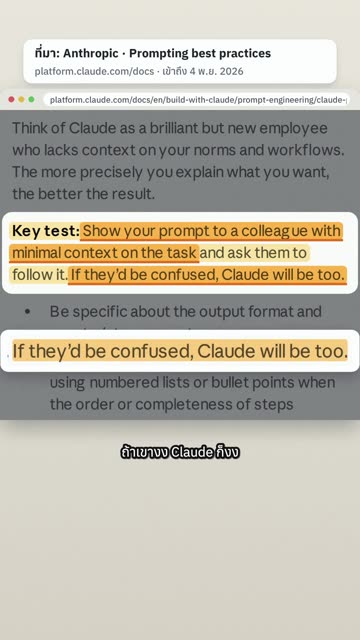
ให้คิดว่า Claude เหมือนพนักงานใหม่ที่เก่งมาก แต่ยังไม่รู้บริบทและวิธีทำงานของเรา และใช้ การทดสอบด้วยเพื่อนร่วมงาน ก่อนส่ง แล้วเขียนคำสั่งให้ครบ 3 อย่าง: งานนี้เอาไปใช้ทำอะไรและทำไม (context/motivation), อยากได้รูปแบบไหนยาวแค่ไหน (output format), และข้อจำกัด (constraints)
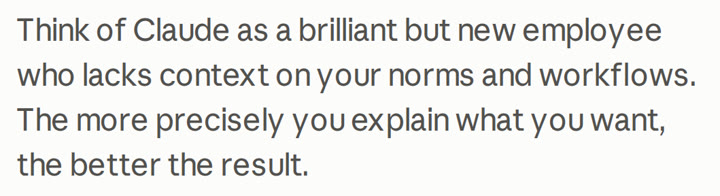
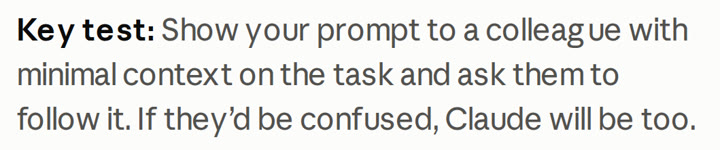
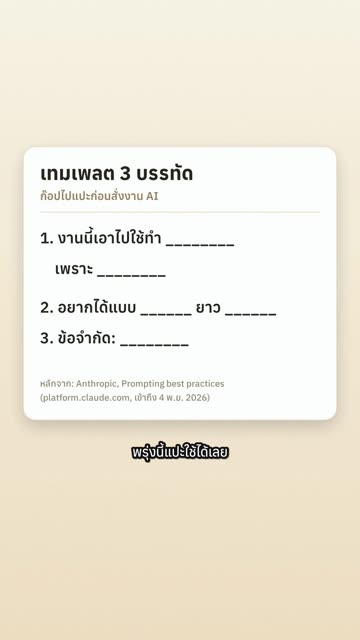
เทมเพลต 3 บรรทัด (ก๊อปได้)
1. งานนี้เอาไปใช้ทำ ________ เพราะ ________
2. อยากได้แบบ ______ ยาว ______
3. ข้อจำกัด: ________
วิธีทำและต้นทุน
| ขั้น | เครื่องมือ | ต้นทุน |
|---|---|---|
| เลือกทิป ตรวจทุกประโยคกับหน้าเว็บจริง (SOURCES.md) | Claude (Lead) + Playwright | - |
| ภาพหน้าเว็บจริง 6 ภาพ + พิกัดบรรทัด | Playwright, Chromium headless, deviceScaleFactor 3 | 0 |
| เสียงพากย์ 55.9 วินาที (1 request) | gemini-3.8-flash-tts, เสียง Umbriel | 0 (free tier, ใช้ 1 จาก 10/วัน) |
| ตัวละครเจ้าของช่อง + keyframe 5 ภาพ | Codex image gen (gpt-6-luna) | 0 (โควตา Codex) |
| 5 ช็อตวิดีโอ + 3 seed สำรอง (S3 S4 S5) | LTX-2.5 distilled int8, ComfyUI บน Colab L4, 768x1344 | ~0.9 หน่วย (session 28 นาที) |
| motion graphic 5 ช่วง 954 เฟรม | canvas JS + Playwright บน Colab CPU 4 ตัวขนาน | ~0.03 หน่วย (2 นาที) |
| Veo | ไม่ได้ใช้ | 0 วินาที |
| ตัดต่อ ซับ เสียง SFX ดนตรี | ffmpeg + ASS (Anuphan), ดนตรี EP1, -14 LUFS | 0 |
| รวม | ยอดหน่วย Colab ลด 154.27 -> 152.59 (1.68) แต่รวม session ของงาน EP6 ที่รันพร้อมกัน | ~0.95 หน่วย (~0.1 USD) |
จุดอ่อนที่รู้ (เรียงตามผลกระทบ)
- ไม่ได้ทำ expert audit ภายนอก: โควตา agy หมด (reset ใน 14 ชม.) ตามบรีฟจึงข้าม ไม่ใช้ DSH ผมตรวจภาพเองจาก contact sheet
- ซับบางบรรทัดเร็วกว่า 15 ตัวอักษร/วินาที (สูงสุด ~20) เพราะเสียงพากย์เร็ว ยืดเวลาค้างให้แล้วแต่ยังไม่ครบทุกบรรทัด
- ครึ่งล่างของจอใน motion graphic ว่าง (กันไว้ให้ซับ) ดูโล่งกว่าช็อต LTX
- S1 และ S4 กล้องซูมเข้าแรงกว่าที่สั่ง ทรงผมหยิกกว่ารูปจริง
- ข้อความบนหน้าเว็บเป็นภาษาอังกฤษ คนดูไทยต้องพึ่งซับ ไฮไลต์ช่วยชี้ แต่ไม่ได้แปลบนภาพ
- เสียง SFX สังเคราะห์ง่ายๆ และยังไม่มีคนฟังรอบสุดท้ายด้วยหู (วัดได้ -14.0 LUFS, peak -1.7 dBFS)
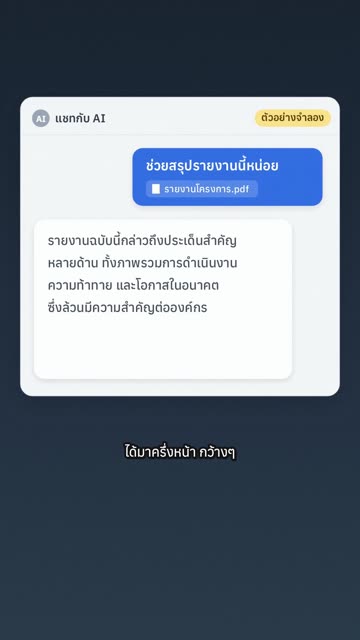
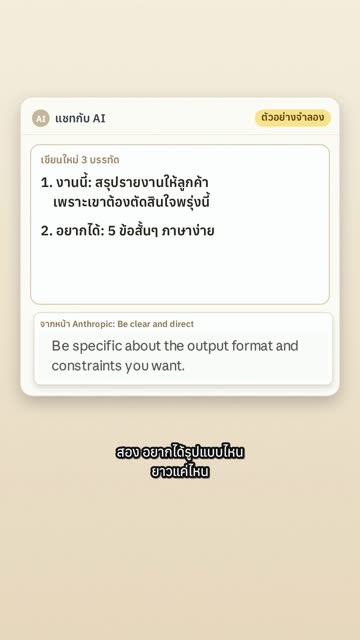
ช็อตทั้งหมด
อภิธานศัพท์ (Glossary)
- Prompt (พรอมต์)
- ข้อความคำสั่งที่เราพิมพ์ให้ AI ทำงาน
- Context (บริบท)
- ข้อมูลเบื้องหลัง เช่น งานนี้เอาไปใช้ทำอะไร ใครอ่าน ทำไมต้องเป็นแบบนี้
- Output format
- รูปแบบผลลัพธ์ที่อยากได้ เช่น 5 ข้อ ไม่เกินครึ่งหน้า
- Constraints (ข้อจำกัด)
- สิ่งที่ห้ามหรือต้องอยู่ในกรอบ เช่น ไม่ใช้ศัพท์เทคนิค
- Key test
- วิธีเช็กในหน้าต้นฉบับ: ถ้าเพื่อนที่ไม่รู้เรื่องอ่านคำสั่งแล้วงง AI ก็งง
- LTX-2.5
- โมเดลสร้างวิดีโอจากภาพแรก ใช้ทำช็อตตัวละคร
- Motion graphic
- ภาพเคลื่อนไหวที่วาดด้วยโค้ด ใช้กับภาพหน้าเว็บ แชทจำลอง และเทมเพลต
- Screen capture
- ภาพหน้าเว็บจริงที่ถ่ายด้วย Playwright ไม่แก้ข้อความใดๆ
- LUFS
- หน่วยความดังเสียง มาตรฐานโซเชียลราว -14
- Colab unit
- หน่วยค่าเครื่องบน Google Colab